用“主方法”算分治算法时间复杂度
课堂导入与主方法初窥
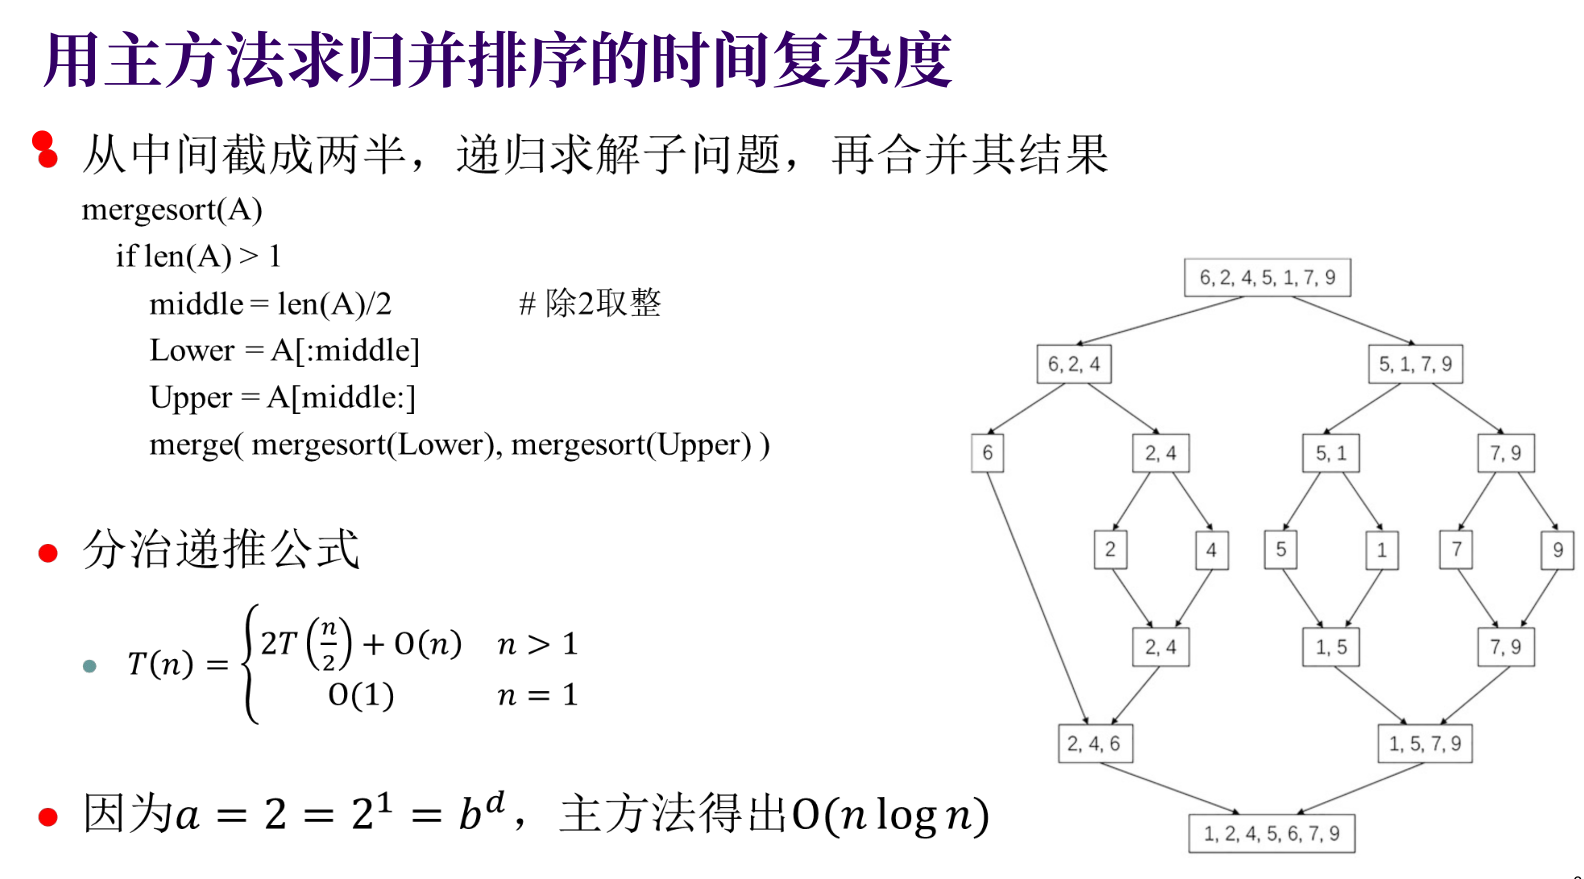
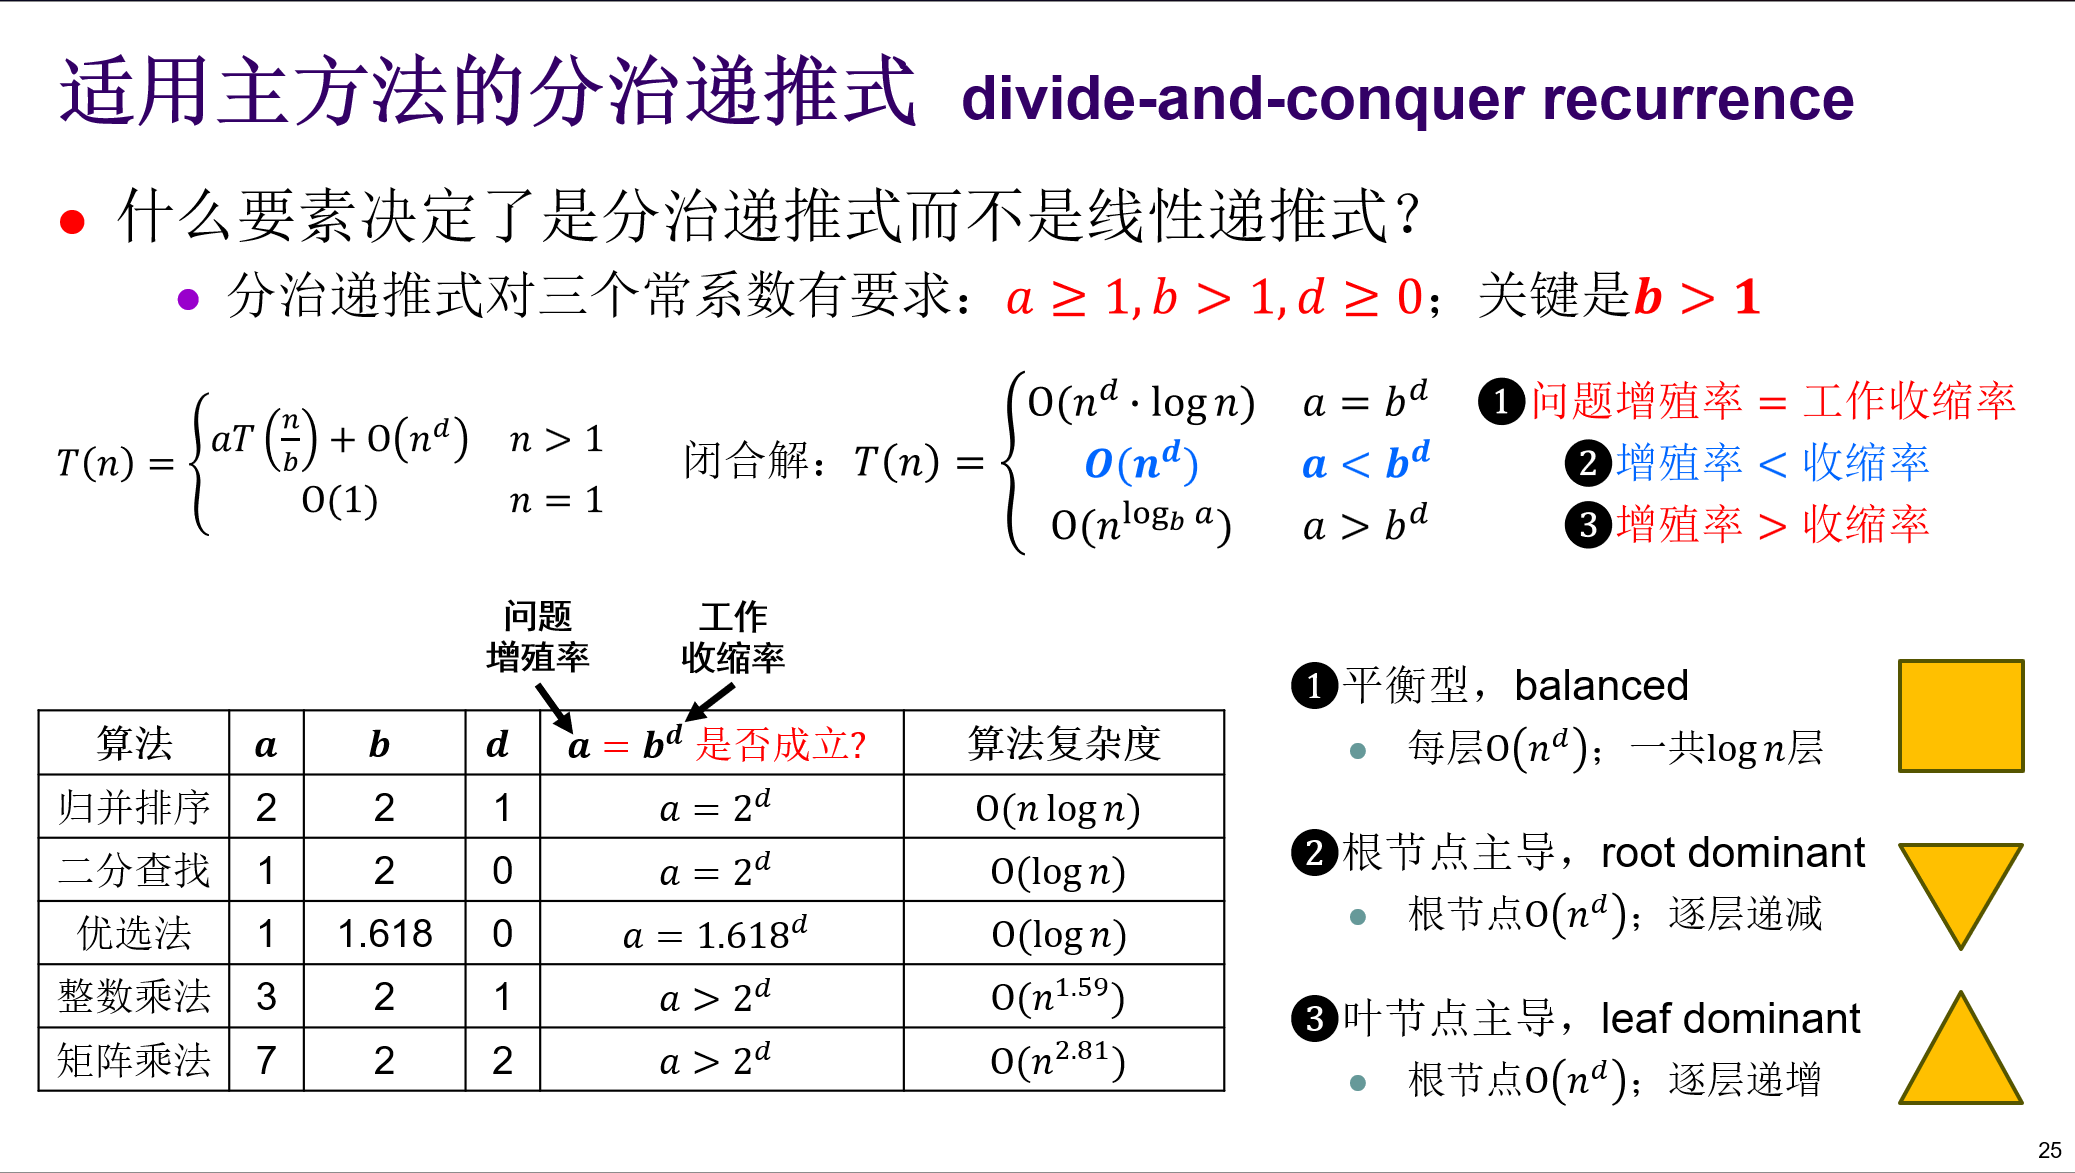 在cs101 spring的第二节课:归纳式与递推式 上,我们了解到了将任务分解与组合来完成,从而降低任务的时间复杂度的概念。但是,要怎么判断一个任务是否适合通过分治(divide & conquer)来进行解决呢?很多人第一反应是画递归树。但当结构变复杂时,画树不仅费时还容易算错。在课件的最后,老师引入了解决这个问题的方法,也就是我们今天的话题:主方法(Master Theorem)
核心公式与“三巨头”(主方法的定义)
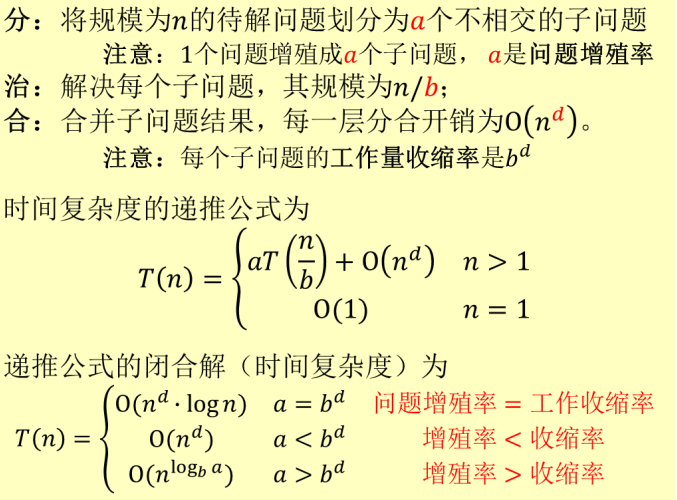
分治算法的时间复杂度通常可以抽象为以下标准形式的递推公式:
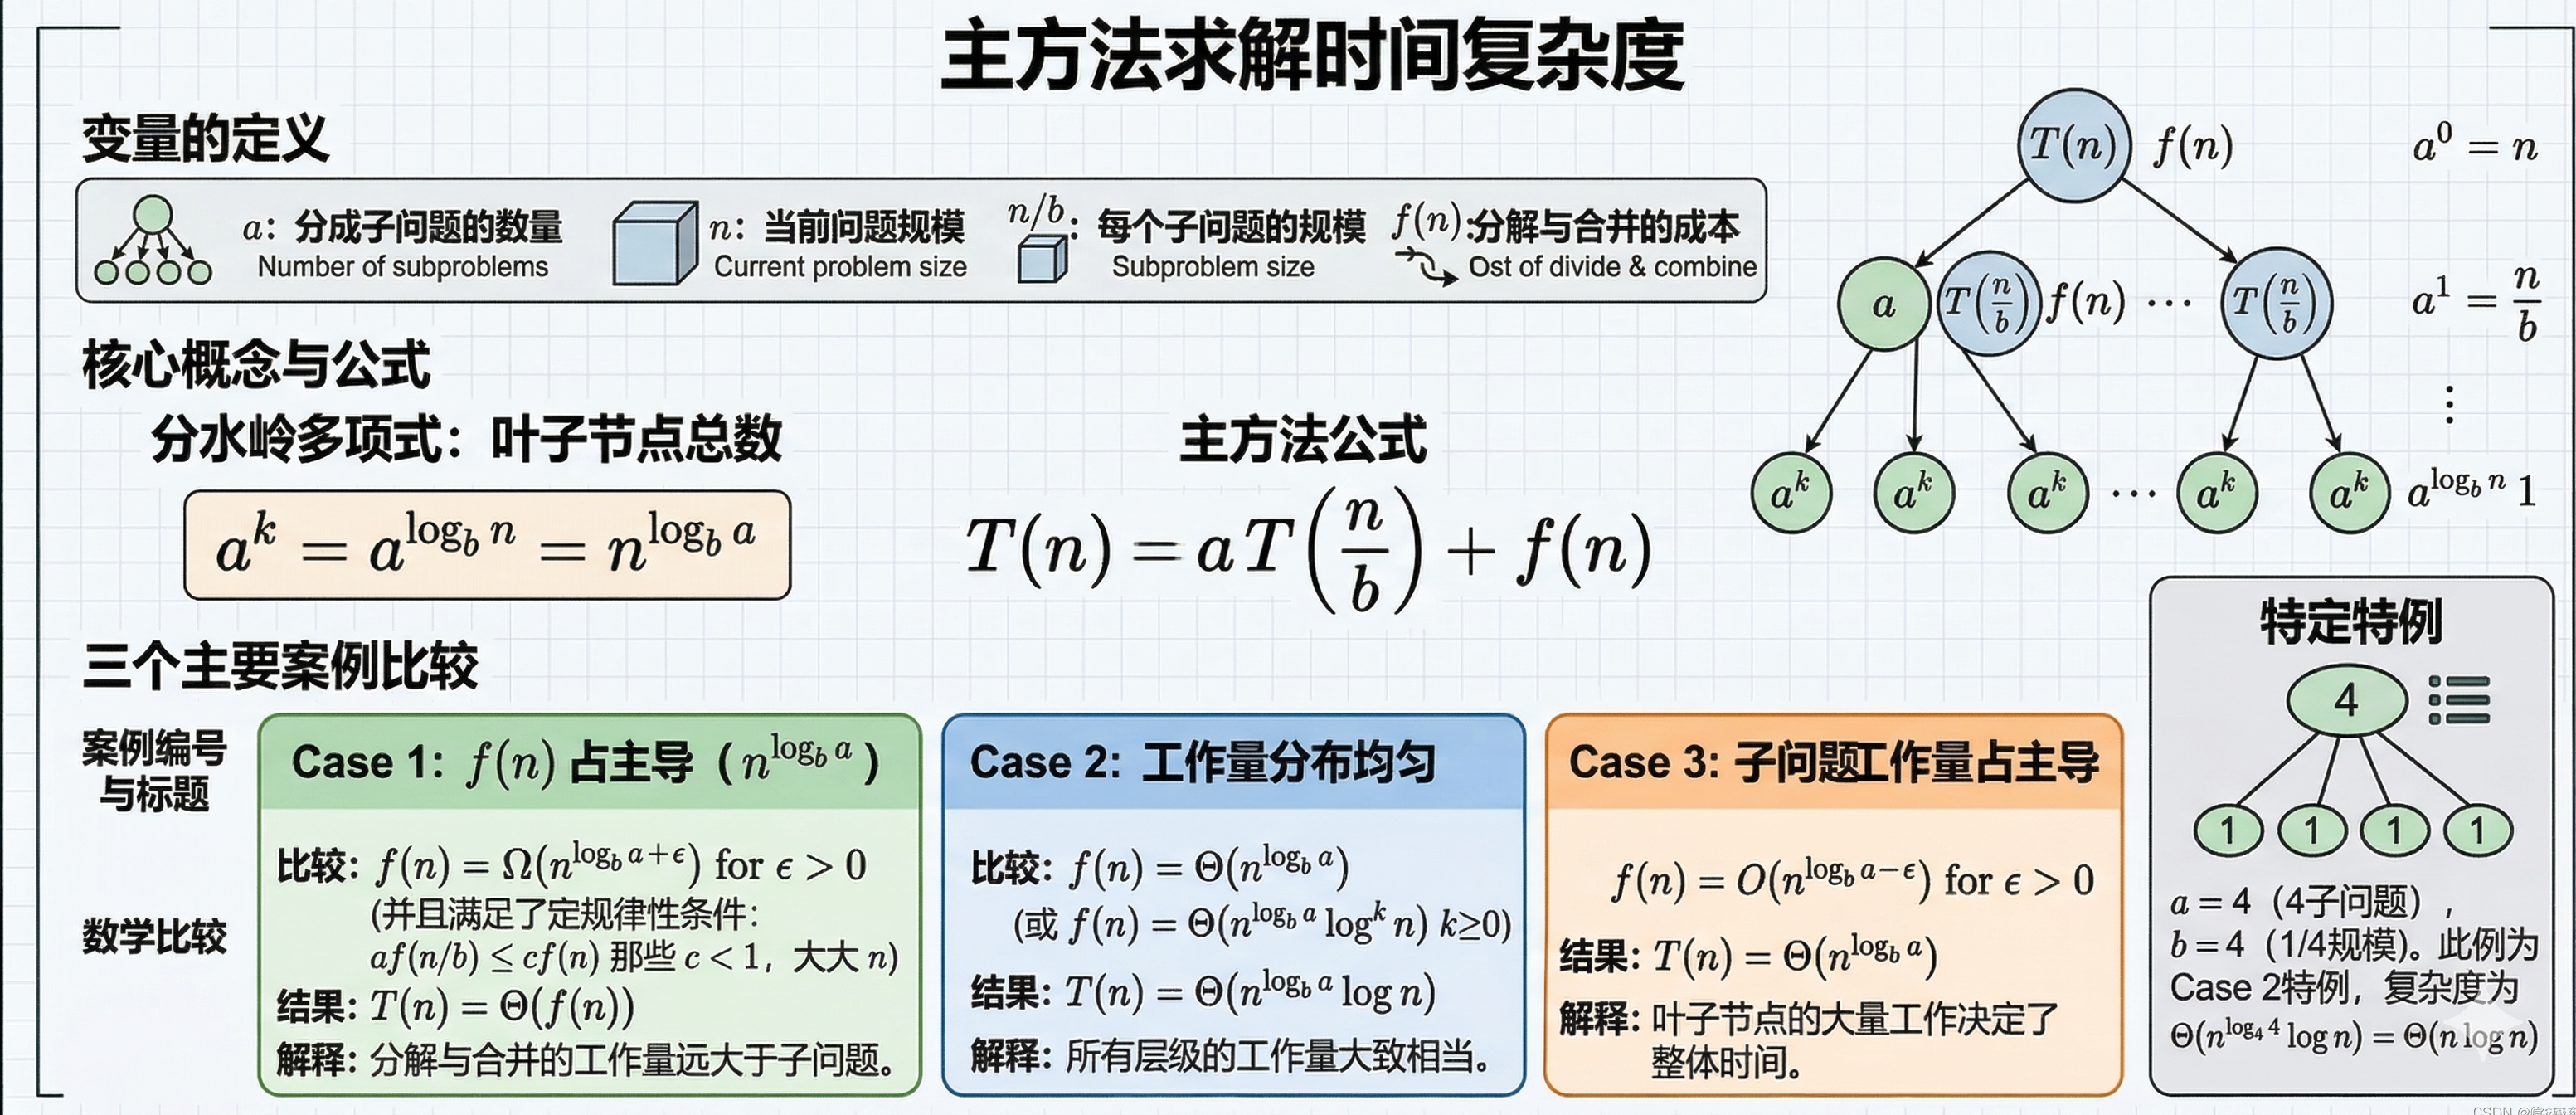
要用主方法,必须满足一个大前提: 且 。公式里的变量分别代表算法的物理执行过程:
- :问题的总规模。
- :每次递归,将问题分解成的子问题数量(分成了几个)。
- :每次递归,子问题规模缩小的倍数(例如 就是对半砍)。
- :分解问题和合并结果所消耗的时间开销。
底层逻辑:一场“根”与“叶”的较量
主方法的本质,是比较**“分解/合并的成本(根节点主导)”和“解决所有微小问题的成本(叶节点主导)”**哪一个更大。
这里引入一个关键的“分水岭多项式”(Watershed Polynomial):,它代表了叶节点的总个数。我们将合并成本 与分水岭多项式进行比较(或者直接比较 和 ),会得出三种情况:
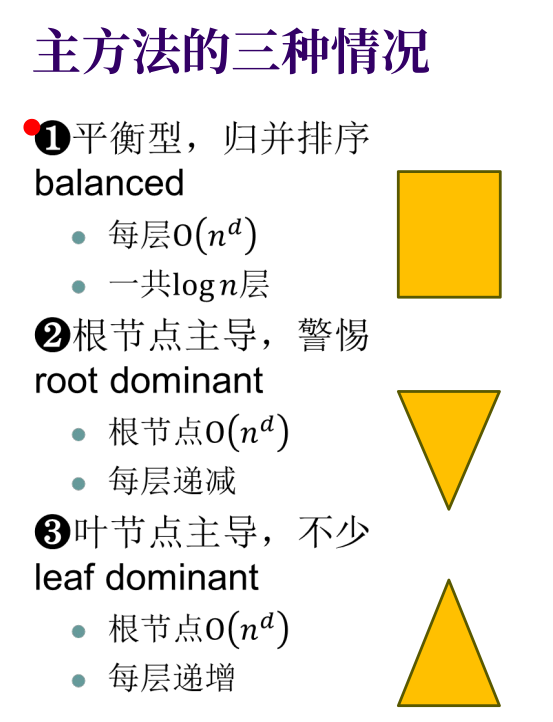
情况 1:势均力敌(各层开销均衡)
- 条件:。递归成本与合并成本在一个数量级 [cite: 15]。
- 结论:每一层的开销乘以层数,复杂度为 。
- 例子:归并排序 (Merge Sort)
- 对半折分(),排两个子数组(),合并时需要双指针线性扫描()。
- ,复杂度为 。
情况 2:根节点主导(合并太费劲了!)
- 条件:。合并成本远大于递归成本,分治反而增加了复杂度。
- 结论:时间复杂度由根节点的合并操作决定,退化为 。
- 例子:暴力计算分界逆序对
- 切两半(),算两边(),但合并时为了找跨界逆序对,使用了双重嵌套循环寻找()。
- ,复杂度直接退化为 。
情况 3:叶节点主导(子问题太多啦!)
- 条件: (问题增殖率 > 工作收缩率)。即余项远小于分水岭多项式,递归成本远大于合并成本 。
- 结论:时间复杂度由叶节点数量决定,为 。
- 例子:分治法求最大值
- 切成两半(),两边都要找(),最后只需做一次比较运算()。
- ,复杂度为 。
⚠️ 避坑指南与拓展
Q: 和 必须一样吗? 当然不是。最经典的例子就是二分查找(Binary Search)。虽然数组在逻辑上被分成了两半(),但我们只去其中一半查找,所以真正执行的子问题数量 。此时 ,,属于情况 2,复杂度为 。
Q: 必须是整数吗? 也不是!看看“反面教材”臭皮匠排序(Stooge Sort):它每次排序前 ,再排后 ,再排前 。一共递归 3 次(),每次规模缩小到原来的 ,所以 。 结果极其糟糕:,比冒泡排序还要慢!这也直观地说明了,如果问题缩小的幅度不够大( 太小),会导致算法性能极其堪忧。
Q: 与 的区别是什么? 是父问题比子问题大的规模倍数(即每次递归搜索时,问题规模缩小的倍数),而 是分治进行的次数(也就是递归树展开的深度)。Q:递归方程 是由哪几部分组成的?主方法的时间复杂度由分成的 个子问题的时间复杂度,加上合并所需的时间复杂度这两部分共同构成。
Q:分解与合并操作的时间参数 怎么理解?有哪些具体实例? 合并与分解的代价通常记为 ,通过以下三个经典的实例可以直观感受不同 值的物理含义:(常数时间): 分治法求数组最大值(Find Maximum using Divide and Conquer)。当底层递归把左右两边的最大值分别返回后,你只需要做一次简单的比较(if left_max > right_max)。无论你的数组原本有多少元素,这最后一步的比较操作永远只需要常数时间 。在渐近复杂度中, 等价于 ,所以 。最终结果:(即 ),属于“叶子节点主导”,时间复杂度为 。
(线性时间):归并排序(Merge Sort)。当左右半边都排好序后,你需要把它们合并(Merge)。这个合并过程不能只做一次比较,你需要设定两个指针,从头到尾挨个扫描并比较这两个子数组中的每一个元素。因此,合并的时间开销与当前处理的数据量 成正比,也就是线性时间 。因为时间开销是一次方的线性增长,所以 。最终结果:(即 ),属于“各层均衡”,时间复杂度为 。
(平方时间):暴力计算分界逆序对(Brute-force Cross-Inversions)。假设我们没有运用归并排序的技巧对子数组进行排序。因为左右两边是无序的,为了找出所有跨界的逆序对,你必须使用双重嵌套循环(Nested Loops)。左右各有 个元素,两两配对比较的次数是 ,得出的合并开销就是平方级的时间 。明确表示时间开销是数据量 的平方,因此 。最终结果:(即 ),属于“根节点主导”,时间复杂度退化为 。这也解释了为什么我们要用归并排序的思路去优化求逆序对的问题,就是为了把 降维成 。